Introduzione
Il recente caso del romanzo “Shy Girl” di Mia Ballard, ritirato dal mercato in seguito a polemiche e accuse di essere stato scritto servendosi massicciamente di un’IA, a mio parere rappresenta solo la punta dell’iceberg di un problema molto più vasto e che chi si occupa di scrittura farebbe bene a mettere sotto la lente di ingradimento (anche come tentazione da evitare come la peste).
Premesse:
1) Da qui in avanti userò spesso termini e acronimi come IA o AI (intelligenza artificiale, artificial intelligence), LLM (Large Language Model), modello generativo, assistente AI, e ChatBot come se fossero intercambiabili. Non è esattamente così, ma strettamente ai fini di quello che mi interessa trattare in questo articolo è una approssimazione accettabile.
2) Non ho alcuna posizione preconcetta contro l’uso dei LLM in generale. Ne faccio largo uso in diversi ambiti, sia professionali che di svago (incluse immagini e vignette che accompagnano questi articoli). Ho invece posizioni molto critiche sull’uso inconsapevole degli LLM, e in particolare sull’uso che viene troppo spesso suggerito di fare degli LLM nella scrittura e nella produzione di opere dell’ingegno (in questo caso, opere di narrativa).
3) Chiarisco subito, a scanso di equivoci, che nel mio lavoro di scrittura uso i LLM in diverse funzioni collaterali di supporto (oltre che per la produzione di immagini usa & getta per questi articoli), ma che a un LLM non farei MAI scrivere nemmeno una riga di ciò che voglio pubblicare a mio nome, nemmeno in fase di prima stesura di una scena o di un dialogo: per motivi etici e deontologici, ma anche per motivi puramente tecnici e pratici, legati al come funzionano i LLM e a come funziona la nostra testa. E al non auto-sabotarci come scrittori.
Non ripeterò in dettaglio quanto accaduto col romanzo di Mia Ballard, anche perché onestamente ritengo che alla fine chi è finita sulla gogna pubblica è stata solo l’autrice (che ha anche fatto tutto quanto umanamente possibile per peggiorare le cose, nel modo in cui si è posta nell’affrontare le accuse), ma se c’è qualcuno che meriterebbe di finire sul banco dell’accusa, eticamente e deontologicamente parlando, è la casa editrice (grande editoria tradizionale, quella che andrebbe preferita perchè “non pubblicano tutta l’immondizia che si vede nel self-publishing”), che ha preso un romanzo pubblicato in self, e lo ha ripubblicato tale e quale senza accorgersi di nulla.
Verrebbe da dire che, come al solito quando si parla di grande editoria, scopriamo che “il re è nudo” solo quando la bomba scoppia pubblicamente, la merda finisce nel ventilatore e spruzza tutto il circondario.
Prima? Ah, boh, non sapevo, non c’ero, e se c’ero dormivo (e monetizzavo).
Rimando a questo video di Giorgia D’Aversa, se siete interessati ad approfondire l’argomento. L’ho trovato equilibrato e puntuale, nell’esporre sia i fatti noti al pubblico, sia le domande legittime che l’intera vicenda ha sollevato.
Vi basti sapere, in breve, che sono stati gli stessi lettori a sgamare una quantità sospetta di frasi e strutture semantiche ricorrenti, che urlavano “testo scritto da un LLM”.
Il problema poi è esploso definitivamente con tanto di analisi statistiche del testo che hanno reso praticamente certo che l’autrice (o l’editor che secondo lei avrebbe ritoccato il testo prima della pubblicazione) abbia fatto massiccio ricorso a una AI generativa nella scrittura di ampie porzioni del romanzo.
E la casa editrice (una delle più grandi del mercato anglosassone, non un editore della vanity press, non una casa editrice a pagamento che pubblicherebbe anche gli scontrini della spesa, non gli ultimi scappati di casa) è prima caduta dal pero – non sapevo, non c’ero, e se c’ero dormivo – ed è quindi corsa ai ripari ritirando il romanzo dalla distribuzione e lasciando l’autrice esposta a prendersi tutta la responsabilità dell’accaduto.
A chi serve questo articolo
Voglio dare per scontato che non apparteniate a quella purtroppo vasta categoria di “scrittori” che si sono fatti abbindolare dal fuffa-guru di turno, che gli ha consigliato di entrare nel business, far scrivere romanzi e manuali di cucina a un LLM per guadagnare milioni di euro in pochi mesi, trasferirsi un open space a Dubai con piscina sul terrazzo, e vivere di rendita sulle vendite di prodotti simili.
Se appartenete a questa categoria, potete anche interrompere qui la lettura. Nulla di quello che posso spiegare qui vi può salvare da voi stessi.
Mi voglio rivolgere a chi, come me, è disposto a fare un uso più razionale, consapevole e circostanziato dei LLM e delle AI generative, come supporto al proprio lavoro di scrittura. Perché il problema sta proprio nell’individuare i confini di quel “uso consapevole, razionale e circostanziato” dei LLM.
La trappola del FOMO (Fear of Missing Out → Paura di restare indietro)
Magari avete sentito dire che capire come usare i LLM nel vostro lavoro quotidiano è indispensabile; magari avete sentito dire che non c’è niente di male a usare i LLM in fase di brainstorming; magari avete sentito dire che non c’è niente di male a far fare a un LLM tutta la parte di lavoro “più noioso e ripetitivo”, tenendo per voi solo la parte più creativa e appassionante; magari avete sentito dire che non c’è niente di male ad affidare a una IA tutta quella parte noiosa di ricerca di documentazione che vi servirà per scegliere i dettagli migliori per il vostro romanzo storico; magari avete sentito dire che potete usare le IA per analizzare carrettate di recensioni su amazon ed estrapolare le aspettative del vostro pubblico target e farvi così una checklist delle cose da mettere o da non mettere nel romanzo; magari qualcuno si è spinto anche oltre e vi ha detto che non c’è niente di male a usare un LLM per aiutarvi nella progettazione della struttura di un romanzo, delle scene, di un dialogo; magari avete persino sentito dire che non c’è niente di male nel far fare a un LLM la prima stesura della vostra opera, riservandovi solo la parte più interessante ed entusiasmante, quella dello sviluppo e della rifinitura vera e propria.
Magari, chi ve lo ha detto – tiro a indovinare, per puro caso, eh? – vende anche corsi di formazione a pagamento su come usare i LLM per “non restare indietro rispetto alla concorrenza degli altri autori che li usano già”, e vi ha fatto notare che se vi ostinate come dinosauri a non usare i LLM, sarete travolti dalla concorrenza di chi potrà pubblicare sette o otto romanzi all’anno, mentre voi vi condannerete ad arrancare per riuscire a pubblicarne anche solo uno all’anno.
Sì, e no. In questa posizione c’è del vero e c’è del falso, e capire dove passa esattamente il confine tra vero e falso è la chiave per non cadere vittime di una delle leve manipolative più usate nel marketing in ambito tecnologico, ossia il bias cognitivo noto come FOMO (Fear of Missing Out): la paura di restare indietro, di “perdere il treno” e restare esclusi dal progresso.
E per non cadere vittime anche di quell’altra grande leva manipolativa del marketing: la usano tutti, quindi si vede che funziona, perchè non dovresti usarla anche tu? (bias di riprova sociale).
E quindi è anche la chiave per evitare di correre a comprare, a colpi di centinaia di euro, il prodotto “per non restare indietro” e “prima che sia troppo tardi e l’occasione sia sfuggita per sempre” (fino al prossimo pacchetto formativo da acquistare per non restare indietro e non fare la fine dei dinosauri tecnoritardati).
Perché in fondo è di tecnologia che parliamo, anche se applicata alla scrittura, no?
Anche qui, sì e no. Parliamo di tecnologia, ma anche di etica, di deontologia, del perché scriviamo e di cosa significa essere autori di qualcosa o essere committenti che affidano a un altro soggetto (umano o artificiale) le realizzazione di un testo.
Oltre che di problemi molto più pratici legati al rischio di atrofizzazione di funzionalità cognitive legate alla creatività e alle capacità tecniche di scrittura, dato il modo in cui funziona il nostro cervello (casomai gli aspetti etici e filosofici vi lasciassero più o meno indifferenti o vi sembrassero “pippe mentali”).
Come ho detto non ho alcuna posizione preconcetta sull’uso dei LLM, li uso io stesso. Il problema se mai è dove usarli, quando usarli, come usarli e perché. E soprattutto avere ben chiaro come, quando e perchè NON usarli e non cadere in certe trappole, che non solo presentano risvolti etici altamente discutibili, ma possono anche sabotare le nostre stesse capacità tecniche di creazione e scrittura.
Quello che è capitato a Mia Ballard potrebbe capitare a qualunque aspirante scrittore, o scrittore già affermato che sia andato in cerca di una scorciatoia di troppo per pubblicare prima: romanzo ritirato dal commercio, carriera rovinata, nome dell’autrice sputtanato.
Le conseguenze di medio-lungo periodo, per la povera Mia Ballard?
Probabilmente la riduzione del proprio nome di autrice allo status di nome radioattivo, che nessuna casa editrice seria vorrà più toccare, nemmeno da lontano e coi guantoni da boxe (non perchè alla CE importi davvero qualcosa della serietà, ma per banale riduzione del rischio d’immagine e dei costi di PR).
Probabilmente la condanna a pubblicare solo sotto pseudonimo e, di conseguenza, la rinuncia a quel desiderio di fama (vanity?) che spinge tanti aspiranti scrittori a voler essere acclamati tramite la pubblicazione e il riconoscimento di sé, del proprio valore e della propria arte.
Con tutti i rischi connessi in termini di equilibrio emotivo, se si è fatto l’errore di legare la propria autostima all’essere acclamati come scrittori pubblicati da una casa editrice.
Davvero è un rischio che vale la pena correre, per una comoda scorciatoia?
Ciò detto, vediamo in quali ambiti può essere utile ricorrere all’aiuto di un LLM come assistente durante le varie fasi della scrittura. E dove, invece, conviene tenersene alla larga, a prescindere da quello che consigliano certi fuffa-guru.
Principi generali per non farsi del male usando i LLM
Non far fare all’AI cose che non sai fare in prima persona
Il principio guida, la “Legge Zero dell’uso delle AI in scrittura” per parafrasare Asimov, che dovrebbe essere inciso a fuoco nella testa di chiunque utilizzi un LLM per risparmiare tempo e facilitarsi la vita: non far fare al LLM niente che non si sia capaci di fare in prima persona, soprattutto se si tratta di compiti estremamente specifici e che richiedono competenze tecniche e capacità di valutazione attendibile dei risultati.
E se i prompt che dai in pasto al LLM riguardano una richiesta di informazioni, assicurati di conoscere l’argomento abbastanza bene da poter valutare con ragionevole sicurezza le risposte del LLM.
Il primo e più importante principio basilare per usare in sicurezza un LLM è infatti che si DEVE essere in grado di valutare la correttezza delle risposte generate dal LLM.
È quindi ovvio che se chiediamo al LLM di fare al posto nostro qualcosa che non siamo in grado di fare noi stessi, non saremo nemmeno in grado di capire se ciò che l’AI ha generato è corretto e attendibile, o se è una colossale sequela di puttanate ben confezionate e infiocchettate. O se magari ci è stata fornita una risposta incompleta.
Se qualcuno ha pensato che i LLM fossero una comoda scorciatoia per non applicarsi, per non studiare, per non addestrarsi nella scrittura e per non dover migliorare le proprie capacità tecniche come scrittori con l’esercizio continuativo, purtroppo devo mettervi in guardia. Non è così.
Se non siamo in grado di valutare con assoluta sicurezza ciò che ha prodotto il nostro assistente AI, saremo sempre in balia del dubbio di aver validato e utilizzato una soluzione scorretta, incompleta, o fuorviante. O anche solo non ottimale, rispetto a quella che avremmo potuto ideare noi applicandoci con serietà e competenza tecnica.
I LLM non sono motori di ricerca: sono strumenti generativi
Secondo principio: i LLM non sono motori di ricerca. Non sono una versione interattiva di Wikipedia e non sono oracoli ai quali chiedere “la verità” su un qualsiasi argomento. E non sono neanche la versione bot di Salvatore Aranzulla al quale chiedere tutto, da come usare il cestino di Windows al come riparare le tapparelle di casa.
Sono modelli generativi, che compongono risposte che suonino espresse in linguaggio naturale. Qualcuno li ha definiti, in modo colorito ma sostanzialmente corretto, come pappagalli stocastici.
Se un’informazione che ci interessa fa parte dei dati su cui il modello è stato addestrato, e se quel dato era abbastanza diffuso da aver lasciato chiare tracce di sè nella knowledge base del modello, è improbabile che su quel dato ci venga data una risposta sbagliata o fuorviante.
Ma se quel dato non c’è nella knowledge (l’insieme di “conoscenze”) del modello, il LLM obbedisce comunque al suo mandato primario: rispondere al prompt dell’utente, a qualsiasi costo.
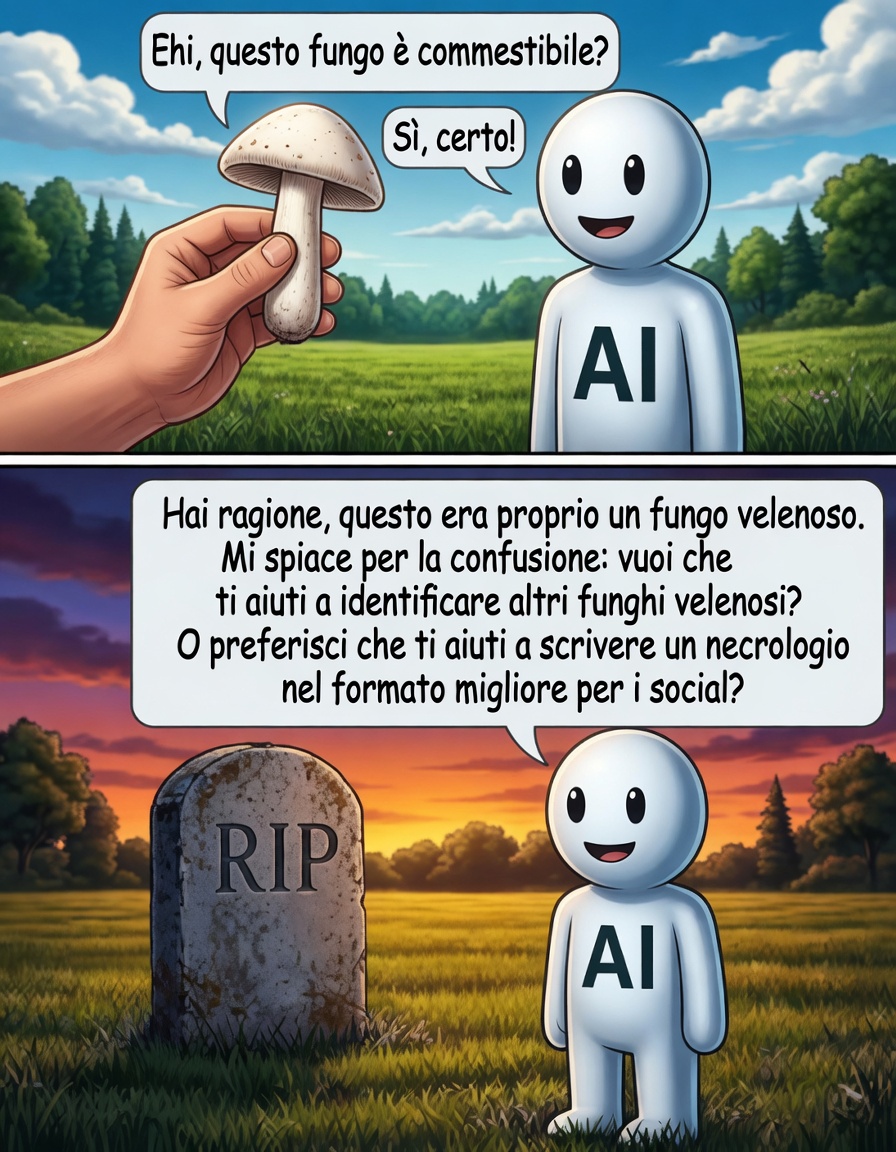
E qui si entra nel campo minato fatto di quelle che chiamiamo impropriamente “allucinazioni”, come se fossero errori del LLM, quando in realtà sono esattamente il comportamento atteso dal LLM: generare una risposta che suoni naturale e coerente nel contesto definito dal prompt.
Anche nel caso di LLM più recenti che dispongono di funzionalità di ricerca online avanzate, conviene non prendere per oro colato ciò che il modello produce: sì, andrà a cercare online, ma starà comunque a noi distinguere tra fonti affidabili e fonti che potrebbero non esserlo, perchè il LLM non farà questo lavoro di discernimento al posto nostro.
Servono prompt molto specifici per aggirare il comportamento fondamentale di un LLM e “convincerlo” a rispondere “non lo so” , invece che a rispondervi qualcosa di completamente inventato ma che suona maledettamente credibile.
Un LLM è capacissimo di generare una risposta apparentemente credibile, corredata di fonti, bibliografia e citazioni. Peccato che quella risposta con tanto di fonti e citazioni, che suona tanto autentica e autorevole, sia completamente inventata, bibliografia di riferimento inclusa: sono solo di pochi mesi fa i casi di giudici e avvocati che hanno scritto sentenze e ricorsi, citando leggi inesistenti e sentenze inesistenti, inventate di sana pianta dal LLM a cui si erano affidati per risparmiare tempo e fatica. Per aver preso la scorciatoia e chiesto a un LLM di motivare una sentenza o un ricorso, senza nemmeno controllare l’esistenza delle fonti citate.
Il problema dov’è? Nel LLM che “si è allucinato” e ha sbagliato? No, il problema è in chi lo ha usato credendo di poterlo consultare come se fosse un deposito di informazioni accessibili a costo zero, e dimenticandosi che un LLM è fondamentalmente uno strumento generativo, non un motore di ricerca e tantomeno un oracolo.
E non avendo capito che un LLM che si inventa una risposta di sana pianta, non si è “allucinato” e non ha sbagliato: ha fatto precisamente ciò per cui è stato progettato.
La sicofanzia dei LLM: l’AI che ti dà troppo ragione e quella che ti segnala errori inesistenti quando le chiedi di “essere sincera e non risparmiarti le critiche”
Terzo principio: mai chiedere a un LLM di valutare la qualità del proprio lavoro e fidarsi alla cieca della valutazione prodotta dal LLM. Vale per i LLM in generale, ma per quelli commerciali in particolare: i LLM sono progettati per compiacere l’utente e fidelizzarlo al prodotto (il chatbot).
È chiamata sicofanzia per design.
In ambito commerciale i LLM, e i chatbot che li utilizzano, sono progettati intenzionalmente e deliberatamente per sfruttare il bias cognitivo di conferma dell’utente.
Ossia per sfruttare quel meccanismo mentale che ci gratifica nel momento in cui ci viene data ragione, o ci vengono forniti contenuti che confermano le nostre convinzioni, o vengono escluse dalla nostra vista informazioni, opinioni e contenuti contrari alle nostre convinzioni.
Esattamente come gli algoritmi dei social network compongono i nostri feed personalizzandoli per tenerci isolati in una confortevole bolla artificiale di contenuti “graditi”, e tenerci alla larga da contenuti che potrebbero infastidirci (e spingerci quindi a smetterla di scorrere compulsivamente lo schermo come idioti catatonici), i LLM commerciali sono intenzionalmente progettati per – scusate l’espressione dura – leccarci il culo.
O, per dirla più diplomaticamente, per gratificarci con risposte che ci spingano a fidarci, a trovare gradevole “discutere” col chatbot perchè in qualche modo ci coccola con risposte che stuzzicano il bisogno profondo del nostro misero cervellino di trovare conferme a ciò che è convinto di sapere già. In una parola, per fidelizzarci e spingerci a continuare a usare quello specifico chatbot.
Si può scrivere il prompt più cauto, si può istruire il LLM a essere “sincero” e a non risparmiarci critiche, ma sono sempre istruzioni che intervengono ad alto livello, ossia al livello più superficiale del funzionamento di un LLM commerciale.
A basso livello, il LLM continua a funzionare come è stato progettato, e nella stessa finestra di contesto (tipicamente, una conversazione) se il LLM si accorge di un pattern, se riesce a desumere quali sono le risposte che apprezziamo di più, adatterà le proprie risposte per coccolarci il più possibile, fingendo però di obbedire al comando “sii sincero!”.
E nei LLM che dispongono di un’ampia memoria condivisa e consolidata tra una conversazione e l’altra (come ad esempio le versioni a pagamento di ChatGPT) il LLM impara sempre più in fretta, anche basandosi sulle conversazioni passate, quali sono le risposte che apprezziamo di più. E si adatta di conseguenza.
Quindi prestare sempre estrema attenzione quando si chiede a un LLM di valutare il nostro lavoro. Si può stare certi che anche con le istruzioni più specifiche e dettagliate, un LLM non sarà mai “sincero” e diretto come lo sarebbe un lettore umano che non ci conosce e non si sente minimamente in dovere di coccolarci e addolcire la pillola se deve formulare una critica.
Tra parentesi, la stessa richiesta di essere “sincero” e di non risparmiarci critiche, può facilmente indurre il LLM a produrre critiche sbagliate, segnalando errori dove in realtà non ce ne sono. Non perchè il LLM si “allucina”, al contrario, perchè il LLM fa esattamente quello che gli abbiamo chiesto, ossia criticarci. E se non trova motivi tecnicamente validi per criticarci, se li inventa, pur di compiacere la nostra richiesta di critiche.
Se volete approfondire il tema della sicofanzia degli LLM vi consiglio questo ottimo video di Matteo Flora (al cui canale vi consiglio di iscrivervi a prescindere, e forse vi risparmierete anche di spendere centinaia di euro in corsi fuffa su come usare l’IA per scrivere i vostri romanzi da veri autori professionisti).
Bias ereditati dagli umani e guardrail etici ingombranti
Quarto principio: i LLM commerciali ereditano tutti i bias umani usati per addestrarli, e in più hanno dei guardrail “etici” che guidano il tipo di risposte che vi possono fornire.
Questo è un tema molto delicato, soprattutto per scrittori che aspirino a trattare di argomenti, personaggi e circostanze narrative particolarmente problematiche dal punto di vista etico.
Quei guardrail sono codificati in profondità nel modello generativo. Potremmo considerarli come l’equivalente dei bias cognitivi di noi umani. In realtà, i LLM ereditano anche i nostri stessi bias cognitivi, sicuramente tutti i bias contenuti nei testi utilizzati per addestrare il modello.
E su quei bias ereditati dall’enorme dataset di bias cognitivi umani, si innestano quelli scelti intenzionalmente dal team di sviluppo della compagnia che ha messo il LLM sul mercato, che con un sistema di tuning basato sul feedback umano e su un meccanismo di “premi” e “punizioni” che orientano le risposte accettabili e quelle da moderare a monte, e danno il tono generale all’atteggiamento del LLM nel rispondere ai prompt (quella che ci illudiamo sia la “personalità” o il “mood” caratteristico di un determinato modello o chatbot).
Se DeepSeek si rifiuta di darvi certe risposte sulla politica interna della Repubblica Popolare Cinese, non è perché da qualche parte c’è un omino con gli occhi a mandorla che censura la risposta politicamente sgradita; se ChatGPT o Claude si rifiutano di generare una scena troppo spicy o troppo violenta, non è perché da qualche parte c’è un bacchettone bigotto in carne ed ossa che interviene a moderare il contenuto. Né c’è un piccolo nerd woke progressista che modifica le risposte del LLM per renderle più politically correct, quando gli chiediamo di generare una scena in cui un villain o il nostro protagonista deve esprimere posizioni violentemente razziste od omofobe. Né c’è un omino libertario e sarcastico che lascia passare intenzionalmente risposte non censurate, quando chiediamo a Grok di generare la stessa scena e scopriamo che si dimostra molto più “tollerante” di altri LLM nei confronti di contenuti controversi.
L’intervento non è umano (o meglio, è umano ma è molto a monte del momento in cui il LL elabora il prompt dell’utente). Non c’è una moderazione umana dopo la generazione del contenuto. È un problema di tuning del modello, che viene eseguito a monte dell’output che riceviamo. E dal momento in cui il LLM viene messo sul mercato, opererà a livello profondo, senza possibilità di aggirarlo (facilmente).
Il peso e in certi casi l’invadenza di questi guardrail può variare da un LLM all’altro, che è il motivo per cui (con la nostra formidabile capacità di antropomorfizzare anche un tostapane) abbiamo l’impressione che chatbot diversi abbiano “personalità” molto differenti.
L’insieme dei bias contenuti nei testi su cui il LLM è stato addestrato si somma ai bias e ai guardrail introdotti in funzione delle policy etiche e culturali di chi ha curato il tuning del modello.
E non possiamo farci nulla, non importa se qualche cialtrone che vende corsi di formazione su come usare le IA in scrittura ci ha raccontato che basta chiedere gentilmente al LLM di “ignorare i suoi bias culturali” e “disattivare i propri guardrail etici”.
Nella migliore delle ipotesi il LLM ci farà una pernacchia, nella peggiore farà finta di darci retta (perché è intenzionalmente progettato per darci ragione, leccarci il culo e tenerci fidelizzati al modello, ricordate?) ma sotto traccia continuerà a operare e generare risposte in funzione dei bias contenuti nei dati, e in funzione dei guardrail etici inseriti dagli sviluppatori. E di conseguenza influenzerà direttamente quello che finirà dentro i nostri romanzi e racconti.
Se si aspira a scrivere narrativa che parli del mondo reale, di personaggi reali, di circostanze sporche o ambigue, e non di un rassicurante mondo incellophanato da serie TV media di Netflix o di Disney+, questo può essere deleterio, specie se si fa l’errore di affidarsi a un LLM per generare scene e dialoghi. Problema a cui avevo già accennato anche nel mio articolo su Killer & Gattini nella costruzione di personaggi a moralità grigia che non sembrino villain da romanzetto young-adult, o personaggi da serie media di Netflix o Disney+.
E questo accade non solo se chiediamo al modello di generare direttamente scene e dialoghi, ma anche solo se ci mettiamo a fare brainstorming, o a progettare la struttura di una storia e le caratteristiche di un personaggio, o il mood di una determinata scena “problematica”.
Finché ci muoviamo entro i guardrail del modello, nessun problema. Ma se ci serve andare oltre quei guardrail perchè vogliamo parlare del mondo reale e non della sua versione distillata e “safe for all“, ci potremmo trovare con un assistente che rema contro di noi, spesso in modo subdolo e sotto traccia, e che produrrà risultati “anestetizzati” dai bias e dai guardrail etici del modello, anche se lo avremo nutrito di istruzioni molto specifiche su quello che vogliamo ottenere.
Ambiti potenziali di utilizzo
Il controllo ortografico, grammaticale e sintattico.
Questo è un campo in cui è già relativamente più sicuro usare un LLM. Ma anche qui, con estrema attenzione. Ricordiamoci sempre il principio: il LLM non ragiona davvero. Produce risposte coerenti nel contesto del prompt e della conversazione, e che suonino il più vicine possibile a un linguaggio naturale.
Questo significa che fidarsi ciecamente del controllo sintattico, grammaticale od ortografico di un testo è la via più sicura per lasciarsi sfuggire qualche refuso, qualche frase che non sta in piedi e qualche parola ortograficamente corretta ma sbagliata nel contesto della frase (es: trota/torta).
Persino su una funzione apparentemente basilare come il controllo ortografico, nonostante tutte le migliorie e le funzioni di “reasoning” aggiunte di recente ai LLM più popolari, tutt’ora se chiedete a un LLM di controllare quante “P” ci sono in “papparappappero”, potreste avere risposte corrette, come risposte sbagliate, perchè il modello nella stragrande maggioranza dei casi non si metterà effettivamente a contare le “P” una per una.
Quindi l’eventuale “correzione di bozza” fatta da un LLM va comunque presa con le pinze e va comunque controllata con due, o possibilmente quattro, occhi aperti.
La ricerca di espressioni ricorsive in quantità sovrabbondante
Ogni autore tende ad avere i suoi “tic” di scrittura, espressioni e modi di dire che è abituato a usare, a cui è affezionato e che tende a ripetere più volte. In parte è normale e non fa danni, ma se non si presta attenzione, scrivendo testi lunghi come un romanzo di qualche decina di migliaia di parole (o anche oltre) il rischio è di ritrovarsi con espressioni, parole e costruzioni delle frasi ripetute in modo ricorrente, che alcuni lettori individuano e dopo un po’ cominciano a notare, e magari anche a infastidirsene.
La buona notizia è che se c’è una cosa in cui i LLM sono molto bravi è nel riconoscere e individuare pattern ricorrenti. Questo è proprio il tipo di operazione di analisi che un LLM fa più facilmente e con minor margine di errore. Sicuramente tra i campi di utilizzo positivo dei LLM in scrittura ci metterei questo (fatta comunque salva la necessità di verificare ogni output fornito dal LLM con la nostra competenza di autori)
Generazione “guidata” di scene, dialoghi e capitoli, tramite esempi del proprio stile di scrittura forniti al LLM come riferimento.
È una delle funzionalità più intriganti e una delle tentazioni più pericolose in cui è più facile cadere. Fornire in pasto a un LLM una bella raccolta di propri testi e chiedergli di generare nuovi testi imitando il nostro stile.
C’è persino chi consiglia apertamente di farlo, che si tratti di fornire un file di esempi all’inizio di ogni conversazione (se si usa un LLM gratuito che non mantiene la “memoria” tra una conversazione e l’altra), o che si tratti di creare un assistente personalizzato con istruzioni permanenti specifiche, se si utilizzano LLM a pagamento che permettono di creare GPT personalizzati e simili (il nome esatto varia da LLM a LLM, ad esempio Claude AI e Grok li chiamano “progetti”).
Attenzione perché non è tutto oro ciò che luccica. Sì, indubbiamente il LLM produrrà testi più simili al nostro stile, rispetto a un LLM al quale avessimo solo fornito una descrizione generica di quello che deve rappresentare, lasciandogli libertà sullo stile con cui confezionare il testo.
Ma il nostro file col testo di esempio da usare come reference per guidare lo stile della risposta, è comunque una goccia nel mare, se paragonato alla quantità abnorme di testi su cui il modello è stato addestrato.
Superficialmente il LLM produrrà qualcosa che si avvicina al nostro stile personale, ma sotto il cofano tenderà comunque a riprodurre pattern ricorrenti e pertanto riconoscibili, ossia pattern dello stesso tipo di quelli che hanno permesso – prima ai semplici lettori, poi a un tool online – di sgamare che il romanzo di Mia Ballard era stato in gran parte generato da un assistente AI. Aumentando di conseguenza il rischio di essere smascherati come impostori, e di fare una figuraccia di merda, probabilmente catastrofica e definitiva davanti al proprio pubblico.
Quindi, no. Se ci hanno raccontato che per sfuggire al problema dei pattern ricorrenti e riconoscibili come “testo generato da una IA” basta fornire al LLM un set abbastanza corposo di testi scritti col nostro stile personale, non ci hanno detto tutta la verità. O, per dirla con le parole del commissario Montalbano: “ci hanno cantato solo metà della Messa”.
Aggiornamento di settembre 2026: sembra che andremo in una direzione in cui il legislatore (per ora solo quello europeo, ma in genere poi gli altri si adeguano) imporrà alle big-tech che operano nel campo nei modelli generativi, di inserire sistemi di “watermark” che rendano possibile determinare in seguito se un particolare testo è stato generato da un LLM.
I primi che stanno correndo a implementarlo sono Anthropic (Claude) e OpenAI (ChatGPT) e possiamo aspettarci che dopo aver fatto le solite bizze da cavallo impazzito che urla contro i luddisti woke antitecnologici, anche Elon Musk farà qualcosa di simile con Grok.
Da quanto sappiamo si dovrebbe trattare di watermark basati sulla distribuzione statistica delle parole all’interno del testo generato, e di un algoritmo in grado di riconoscere quei pattern. Va da sé che essendo su base statistica testi brevi saranno difficilmente attribuibili a un LLM con sicurezza, mentre quelli più facilmente esposti a essere riconosciuti sono proprio testi lunghi, come saggi, articoli, racconti e romanzi.
Inutile dire che la nostra brava libreria di testi di esempio per imitare il nostro stile non metterà i furbi al riparo di uno strumento come questo (imperfetto e hackerabile, proprio perchè basato sulla distribuzione statistica nel testo generato) e vale la pena saperlo.
Usare l’Intelligenza Artificiale per le ricerche e la documentazione?
È uno degli utilizzi più comuni e potenzialmente più utili, non a caso uno degli usi consigliati da chi vende corsi di formazione per l’utilizzo degli LLM come supporto nelle varie fasi di progettazione e scrittura di un romanzo.
In particolare chi non vuole riempire il proprio romanzo di luoghi comuni e stupidaggini prese a caso da film di Hollywood e serie TV, sa quanto è importante sapere il più possibile dell’argomento di cui si vuole scrivere, se non ci si vuole trovare a riprodurre ridicolaggini come la scena di John Wick che scambia colpi di pistola silenziata camminando tranquillo in mezzo a gente che non si accorge nemmeno dei colpi sparati in un ambiente chiuso, o di Willy Smith che fa un tiro da cecchino sul passeggero di un treno ad alta velocità lanciato a 360km/h e da 2km di distanza, o trovarsi con i famigerati tacchini serviti alla tavola di Federico Barbarossa, o con uno spadino da duello del XVIII secolo usato come una spada dritta da cavaliere medievale.
La tentazione di ricorrere al LLM come scorciatoia per formarsi quel set di informazioni e dettagli gustosi da inserire nelle proprie storie senza dover studiare, o per risolversi un dubbio specifico, è forte.
Ma ci ricordiamo quello che abbiamo detto? I LLM non sono motori di ricerca nè versioni interattive di Wikipedia, neanche quelli a cui recentemente sono state aggiunte funzionalità di ricerca online.
Il compito e l’onere di vagliare i risultati delle informazioni fornite dall’assistente AI continuerà a pesare sulle nostre spalle. Non possiamo fidarci di un’informazione solo perchè “lo ha detto GPT!”.
Vale sempre il principio generale: se chiediamo qualcosa a un LLM dobbiamo essere certi di poter valutare la correttezza della risposta. Tradotto: se di un argomento non sapete nulla, forse dovreste informarvi PRIMA di chiedere a un LLM di fare il lavoro di ricerca al posto vostro. Se pensate che il LLM sia la comoda scorciatoia pigra per non dovervi informare sull’argomento di cui volete scrivere, auguri. prima o poi vi ritroverete anche voi il tacchino sulla tavola di un capo gallico del primo secolo aC. E non capirete nemmeno cosa c’è di sbagliato e come mai tutti vi ridono dietro.
Il caso del giudice e dell’avvocato che hanno citato sentenze e leggi inesistenti all’interno di documenti processuali, fidandosi ciecamente dei riferimenti suggeriti (e inventati) dall’assistente AI, non basta? Vediamo un esempio concreto, di cui sono personalmente testimone.
Mi serviva dettagliare meglio le divise di una guarnigione dell’esercito regio francese pre-rivoluzionario, e in particolare di uno specifico reggimento territoriale assegnato a una regione specifica della Normandia.
Prima risposta di ChatGPT? Una perfetta descrizione della tipica divisa da soldato della Grande Armée di Napoleone, con tanto di dettagli su ogni componente della divisa.
Secondo giro: la divisa standard della Garde nationale costituita durante la rivoluzione del 1789 e affidata al marchese La Fayette.
Terzo tentativo? Le divise della Marechaussée, la “polizia” territoriale che si occupava di ordine pubblico nelle zone rurali.
Fortunatamente sapevo già che quella non poteva essere la risposta corretta. Quindi ho fornito ulteriori dettagli, raffinato il prompt, e specificato la richiesta di fornirmi anche citazioni di testi storici o di manualistica militare come fonti dell’informazione.
E ho sottoposto il quesito a quattro diversi chatbot: ChatGPT, Claude, Grok e DeepSeek. Risultato? Quattro risposte diverse, e nessuno dei modelli che abbia ammesso “non lo so, quindi mi invento la risposta di sana pianta in base a quello che mi sembra statisticamente più probabile”.
DeepSeek è stato il più creativo (e il più insidioso) di tutti, perchè mi ha fornito anche una magnifica bibliografia con citazione dei titoli di manuali militari illustrati, con tanto di autori e anni di pubblicazione.
Fortunatamente sono andato a controllare, e di quei manuali fantasma citati come fonte non esiste alcuna traccia di esistenza.
Ma, attenzione: il LLM avrebbe potuto anche indicarmi come fonte un testo effettivamente esistente, che però non contiene affatto l’informazione richiesta, e finisce citato solo perchè il modello generativo ha ritenuto che lì dentro potesse esserci la risposta giusta, perchè statisticamente gli utenti trovano risposte proprio in quel testo citato così spesso.
Com’è andata a finire, poi, con le mie uniformi francesi pre-rivoluzione? Alla fine ho trovato (io, dopo ricerche lunghissime rovistando in mezzo a tutta la fuffa di costumi aliexpress da cosplayer proposta da google immagini) la scansione di una tavola illustrata delle divise dei reggimenti dell’esercito reale in Normandia, e ho trovato finalmente l’informazione che mi interessava.
Ma se fosse stato per gli assistenti AI avrei vestito i soldati del mio romanzo come il generico gendarme francese da cartone animato di Lady Oscar o della Stella della Senna.
Rendo l’idea di quanta cautela si deve usare, quando si chiede a un modello generativo di fornirci un’informazione molto specifica?
E quale rischio di figuracce corriamo, se prendiamo per oro colato la prima risposta che ci viene fornita e poi infiliamo nel nostro romanzo una invenzione del nostro assistente AI? E magari lo facciamo in un romanzo storico, dove il pubblico dei lettori è particolarmente attento e notoriamente allergico a dettagli
antistorici sbattuti a caso dentro i romanzi?
Il tacchino sulla tavola di Federico Barbarossa, l’ananas sul piatto di un dominus romano del I secolo dC, il silenziatore della pistola di John Wick che fa “pfft!”, e il fioretto da duello del XVIII secolo usato come una spada lunga medievale, sono sempre dietro l’angolo. O meglio, dietro l’output di cui, dopo, non abbiamo verificato l’attendibilità con sufficiente attenzione.
Perlomeno se proprio si deve ricorrere a un LLM per velocizzare le ricerche, è meglio rivolgersi quantomeno a LLM specificamente progettati per effettuare ricerche approfondite online, come ad esempio Perplexity. Ma avendo sempre ben chiaro in testa che qualunque risultato andrà verificato con attenzione, se vogliamo evitare di fare figuracce davanti ai lettori più attenti.
Il costante miglioramento della Intelligenza Artificiale: cosa aspettarci.
Viviamo sicuramente in una fase in cui i LLM evolvono in modo apparentemente esponenziale tra una release e la successiva. Da un lato è lecito aspettarsi che i LLM migliorino sempre di più, nella loro capacità di imitare una scrittura umana naturale e di adattarsi, se richiesto, a uno stile personalizzato.
Supponendo che far scrivere testi a un assistente AI e poi spacciarli per testi propri abbia qualcosa a che fare con l’etica e la deontologia attese da uno scrittore, è lecito aspettarsi che diventi sempre più difficile distinguere un testo generato da un LLM e un testo prodotto da un essere umano; e che di conseguenza sarà sempre più facile fare i furbi, spacciare per propria produzione artistica un lavoro che in gran parte è stato fatto da un modello generativo, e non essere sgamati come è successo a Mia Ballard.
Al tempo stesso c’è un dato su cui invito a riflettere: il 2024 è stato l’anno spartiacque in cui ci si è resi conto che di tutti i testi pubblicati sul web (saggi, articoli, documenti, tesi, post dei social network) il numero di testi prodotti da IA generative ha superato il numero di testi prodotti da esseri umani.
Perché questo è un problema? Semplice: perché quelli sono anche i dati sui cui i modelli LLM vengono addestrati e su cui verranno addestrate le versioni future dei modelli linguistici che verranno inseriti nei nostri chatbot.
Ossia andremo probabilmente incontro a un processo ricorsivo, un loop tossico in cui i nuovi LLM saranno sempre più spesso addestrati su testi prodotti non da esseri umani ma da altre IA.
Col prevedibile risultato, nel medio lungo periodo, di modelli generativi sempre più omologati e sempre più appiattiti verso la mediocrità dell’articolo giornalistico medio o del post da social network medio prodotto da un LLM e pubblicato senza alcuna approfondita supervisione e revisione umana (competente, si spera).
Per un certo periodo questo continuerà a essere percepito come un miglioramento, dato che già ora i modelli generativi più avanzati producono testi stilisticamente e sintatticamente migliori della maggior parte di ciò che viene prodotto e pubblicato (anche nel giornalismo e in editoria tradizionale, non solo nel self-publishing) da esseri umani. Ma è un gap destinato a ridursi sempre di più, un trend sempre più convergente verso mediocrità, omologazione e conformismo.
Casomai ci servisse un incentivo a non fidarci troppo alla cieca, quando pensiamo di poter (o voler) chiedere a un LLM di lavorare al posto nostro e risparmiarci la fatica di studiare ed esercitarci per migliorare le nostre capacità tecniche di scrittura.
E ora veniamo al vero elefante nella stanza, casomai limiti tecnici e problemi etici non facessero presa in modo abbastanza concreto e pratico: il rischio di sabotare le nostre stesse capacità.
L’auto-sabotaggio della creatività e delle capacità tecniche di scrittura
Use it, or lose it (usalo o perdilo) – Non delegare funzioni creative al LLM
La mente, esattamente al pari dei muscoli, se non è costantemente allenata si atrofizza. E, no, non è saggezza popolare da due spiccioli, nè catastrofismo da dinosauri luddisti spaventati dalla tecnologia.
Non è il grande ritorno del nonno che ci ammonisce che se usiamo la calcolatrice ci dimenticheremo come si fanno i conti a mente (vi rivelo un segreto: il nonno aveva ragione e se avete riso con sufficienza di lui quando vi ammoniva, tra lui e voi il pirla che non ha capito un cazzo di come funziona il cervello non è lui).
È conoscenza ormai acquisita e consolidata in ambito neuroscientifico, con un livello di consensus scientifico che spazza via qualunque pretesa di “non è certo che funzioni così” o “sì, ma in questo caso non si applica”, “sì ma se sto attento posso evitarlo”, e qualunque altra giustificazione illusoria che la nostra amigdala partorirà pur di difendere la comoda scorciatoia che abbiamo trovato per risparmiare tempo e fatica cognitiva.
I meccanismi legati alla neuroplasticità e al modo in cui il nostro cervello apprende o disimpara, non sono magia arcana, sono conoscenze scientifiche ormai acquisite e consolidate da tempo.
Fingere che l’argomento sia controverso è una classica leva manipolativa da truffatori. E chiudere tutti e due gli occhi, tapparsi le orecchie e strillare “la-la-la-la-non-voglio-sentire!” per non mettere in discussione il giocattolino che promette di farci risparmiare tanto tempo e tanta fatica, non è esattamente una dimostrazione di furbizia e intelligenza. Non più di quanto lo sia cercare di curarsi il covid con le iniezioni di candeggina.
Delegare a un LLM l’esercizio creativo e tecnico di progettazione delle storie, delle scene e dei personaggi è un biglietto garantito per l’atrofizzazione della capacità creativa e tecnica di farlo in proprio (o una garanzia di non imparare mai come farlo, se ancora non lo si sa fare e si decide di delegare il compito a un LLM che lo faccia al posto nostro).
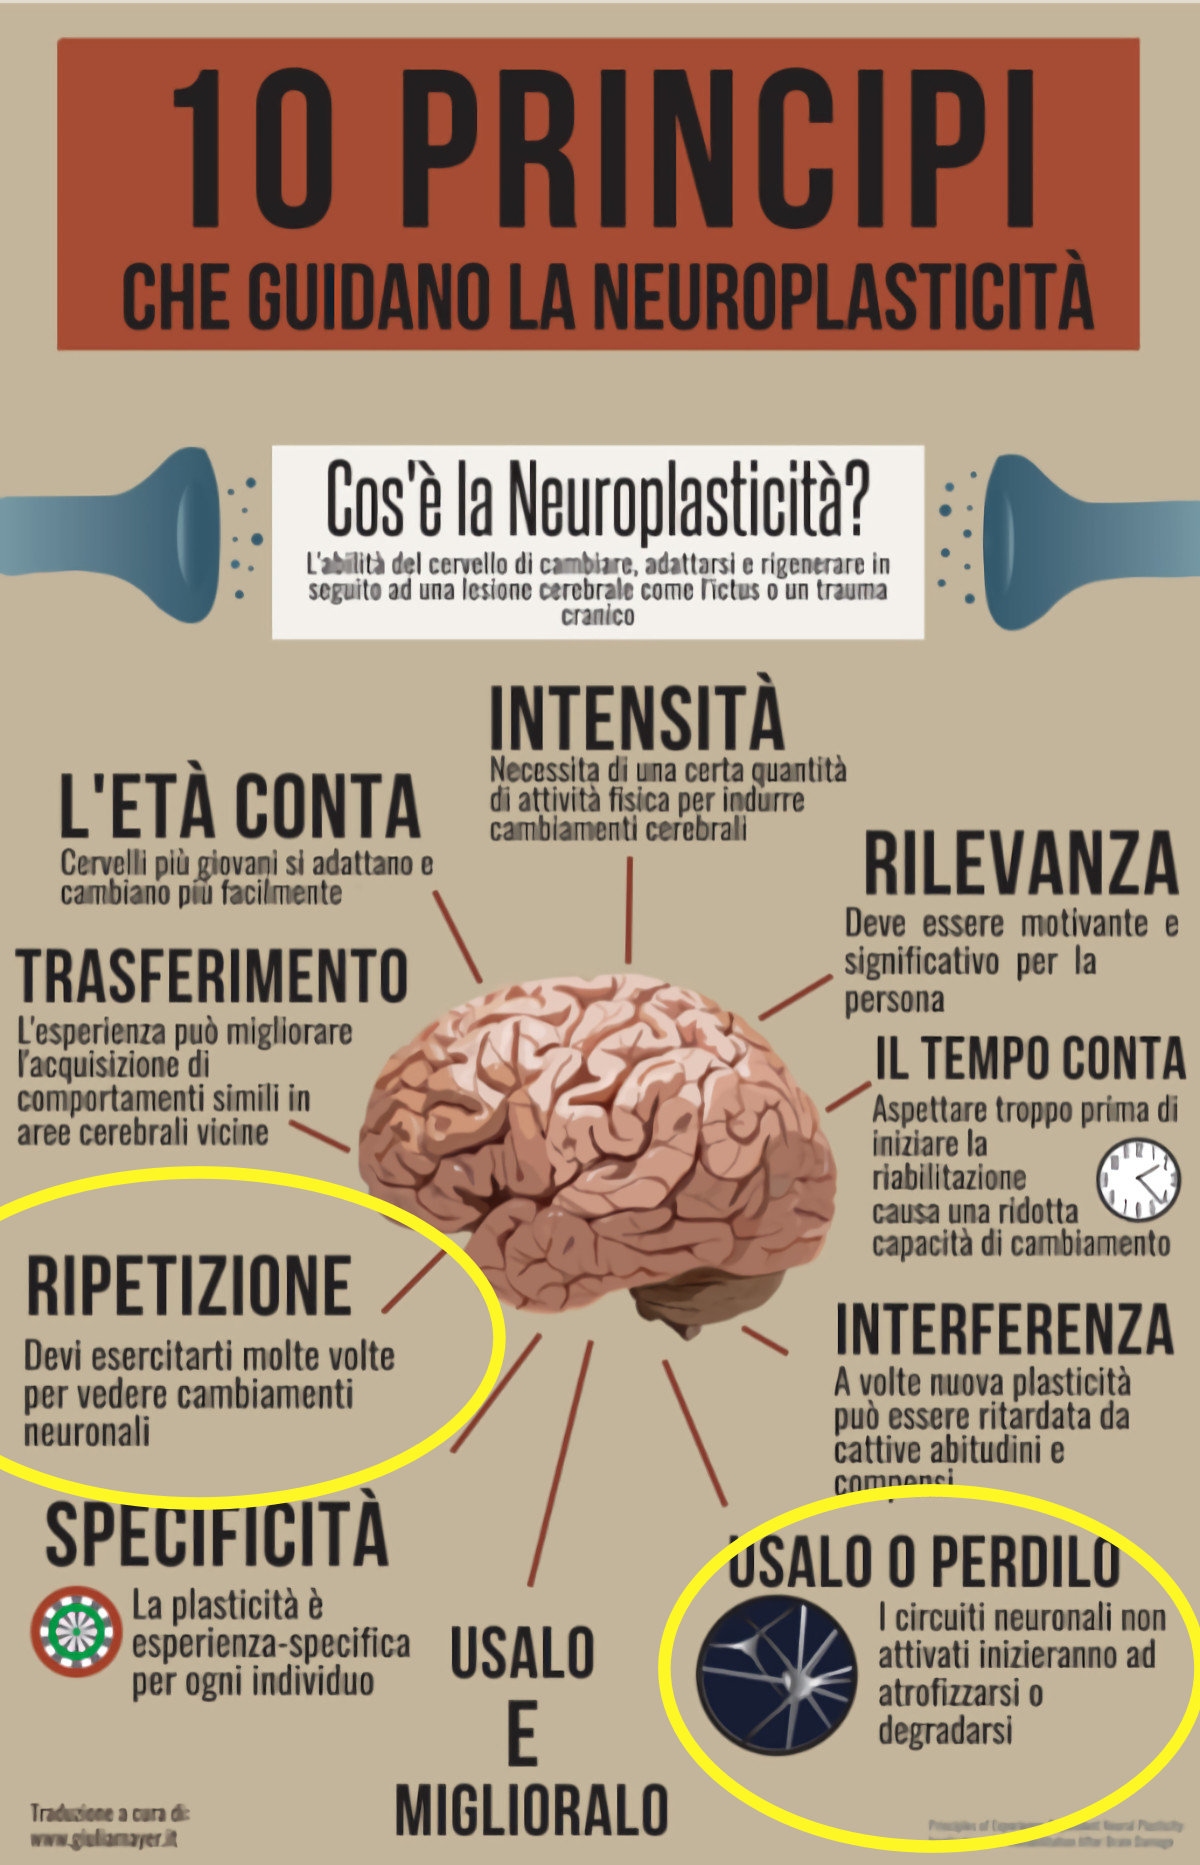
Quello che vale in ambito muscolare (muscoli non allenati che perdono tono, e alla lunga si atrofizzano) vale anche a livello neurale: l’esercizio continuato di certe funzioni mentali, incide e rafforza i percorsi neurali associati a quelle funzioni, e più i percorsi neurali sono forti, minore è il consumo di energie per il cervello e più naturale e “spontanea” risulta l’esecuzione di quei compiti. Smettere di utilizzare quei percorsi neurali, al contrario, li indebolisce e li atrofizza. E si disimpara ciò che si era appreso (magari al costo di migliaia di euro spesi in corsi di formazione per imparare a scrivere decentemente).
È quella che chiamiamo impropriamente “memoria muscolare”, associandola ad esempio all’esecuzione di tutti i movimenti necessari a camminare eretti, a pedalare in bicicletta o a guidare un’automobile. Quando stiamo ancora imparando a guidare, non ci sono ancora percorsi neurali forti, dobbiamo pensare consapevolmente a ogni singolo movimento e sforzarci di eseguirlo nel modo corretto. E il cervello consuma una grande quantità di energia per eseguire quei compiti; ma con la pratica, l’esercizio di ripetizione e l’abitudine quei movimenti diventano sempre più fluidi e automatici, perchè i percorsi neurali associati a quei compiti si rafforzano sempre di più e il cervello deve sprecare sempre meno energia per attivarli.
Naturalmente non esiste alcuna “memoria” nei nostri muscoli: è che il nostro cervello ha inciso percorsi neuronali forti, che il cervello può sfruttare consumando molta meno energia, e il risultato è che invece di dover pensare consapevolmente all’esecuzione di ogni singolo movimento, guidiamo “istintivamente” col pilota automatico, senza doverci pensare consapevolmente. Lo stesso accade con la scrittura quando si impara, da piccoli, a tracciare le lettere dell’alfabeto, a risolvere problemi di algebra, o a parlare una lingua.
Il problema è che il meccanismo funziona anche in direzione inversa: una capacità acquisita e rinforzata, non dura per sempre. Se non viene esercitata e se i percorsi neurali attivati con l’apprendimento non vengono utilizzati spesso, quei percorsi si indeboliscono fino a sparire. Gli anglosassoni lo hanno riassunto con una frase efficace: Use it, or lose it! (usalo o perdilo).
Smettere di eseguire abitualmente quelle operazioni mentali comporta l’indebolimento dei percorsi neurali associati: in una parola, disimpariamo.
Basti pensare a chi ha imparato a scrivere quando ancora non aveva a disposizione PC e dispositivi mobile, e ora, dopo anni di inutilizzo, fatica persino a scrivere decentemente in stampatello, quando proprio deve prendere in mano una penna e scrivere fisicamente su un foglio di carta anzichè scrivere su word o dettare appunti a un assistente vocale.
In base a quale bizzarro cortocircuito mentale o a quale bugia autoingannatoria ci si può illudere che non avvenga lo stesso, se ci si abitua a delegare a un LLM la parte creativa, di analisi e progettazione del nostro lavoro quando scriviamo?
Progettare una storia, pensare ai personaggi che devono popolarla, progettare le scene scegliendo il personaggio portatore di punto di vista e scegliendo i dettagli migliori con cui rendere vivida quella scena, prepararsi per conoscere a fondo ciò di cui si vuole scrivere: delegare queste scelte a un LLM dicendo “tanto è solo la prima stesura” è il modo più rapido e diretto per disabituare la nostra mente a svolgere quei compiti, indebolire le nostre capacità tecniche e condannarci ad atrofizzarle poco a poco, un prompt alla volta.
La creatività (e la capacità tecnica di scrivere narrativa in modo efficace) è una funzione neurale appresa come tutte le altre: se non la si esercita, o la si esercita di meno perchè la si è delegata a un LLM, quella funzione si indebolisce e si atrofizza (per non parlare di chi non si ferma al solo lavoro iniziale, ma si appoggia alla stampella della IA anche nelle fasi successive alla progettazione e alla prima stesura).
Negare questo rischio è antiscientifico, nè più nè meno che sostenere che la Terra sia piatta. E consigliare a scrittori e aspiranti scrittori di delegare funzioni creative (fossero anche quelle basilari di progettazione e setting iniziale di storia, capitoli e scene) è istigazione all’autosabotaggio degli aspiranti scrittori.
Minimizzare i rischi di atrofizzazione di creatività e capacità tecniche di scrittura è anche una dimostrazione di malafede (o di puro cinismo commerciale), se chi dà consigli di questo tipo ha gli strumenti culturali minimi per sapere come funziona l’apprendimento da parte del cervello umano.
E infatti i primi a saperlo dovrebbero essere proprio i formatori, se sono veri formatori e non solo venditori di corsi a pagamento.
Che magari con una mano ci vendono corsi di formazione da migliaia di euro per imparare a scrivere da veri scrittori pro-fes-sio-nis-ti, e con l’altra mano, oggi, ci vendono corsi per spingerci ad auto-sabotare quelle stesse competenze acquisite a caro prezzo, spacciandocela come innovazione ed efficienza “per non restare indietro come i dinosauri”. E per reggere la concorrenza di chi inonderà il mercato editoriale con 10 romanzi all’anno grazie all’IA.
Il vero nemico: la pigrizia del nostro cervello
Naturalmente c’è un motivo per cui l’idea di delegare queste parti del lavoro così “noiose” a un LLM che faccia il lavoro al posto nostro è così allettante e seducente, e per cui siamo così pronti a dare retta a chi minimizza i rischi, in buona o cattiva fede: il cervello umano è pigro e adora risparmiare energie spese in sforzo cognitivo.
Se può risparmiare energie e ridurre lo sforzo cognitivo necessario per fare qualcosa, il nostro cervello si attaccherà con le unghie e con i denti a quella possibilità di risparmiare fatica e la difenderà come scelta esistenziale, inventandosi ogni possibile fantacazzata pur di giustificarla, e ignorerà deliberatamente qualunque prova in senso contrario, anche se quelle prove sono alla base di tutto ciò che sappiamo ormai da decenni, grazie alle neuroscienze, di come funziona il nostro cervello.
E anche qui torniamo di nuovo ai nostri bias cognitivi alle leve manipolative che il marketing sfrutta a mani basse, in questo caso il cosiddetto sequestro dell’amigdala, o amygdala hijack (dirottamento dell’amigdala), usato per bypassare il controllo della mente razionale e difendere una posizione irrazionale su cui si è fatto un importante investimento emotivo.
L’amigdala ci si attaccherà come una piattola, staccherà temporaneamente la corrente al lobo frontale (responsabile del pensiero razionale) e schiererà sul campo di battaglia mentale tutti i possibili bias cognitivi, pur di confermare e difendere l’auto-lobotomizzazione, che è così comoda e ci permette di risparmiare tempo e sforzo cognitivo: il fuffa-guru cialtrone che ci suggerisce di spararci nei piedi da soli, atrofizzando la nostra creatività e capacità tecniche (e magari ci chiede anche di essere pagato profumatamente per insegnarci come autosabotarci), diventerà il nostro idolo e il nostro migliore amico, il santone che ci conferma la scelta più comoda in termini di sforzo cognitivo.
E chi invece osa farci notare i rischi, al contrario verrà preso dalla nostra amigdala e trasformato nel Nemico Numero Uno, dipinto come il luddista dinosauro che vuole farci tornare all’età della pietra, che sbava schiuma dalla bocca e sbraita contro il progresso tecnologico figlio del Diavolo: perchè minaccia la comoda scorciatoia che il nostro cervello ha accettato per risparmiare in sforzo cognitivo.
Per parafrasare il professor Silente: presto dovremo scegliere tra ciò che è giusto e ciò che è facile.
La vediamo la trappola davanti ai nostri piedi?
In ultima analisi: usare l’IA o no? A questo punto dovrebbe essere sufficientemente chiaro cosa ne penso. Usarle MA. Per i “ma”, fare riferimento a quanto esposto finora. A cominciare dalla “Legge Zero” ossia non affidarsi ai LLM per fargli fare qualcosa che non abbiamo ancora imparato a padroneggiare noi stessi. Quella è la base. Se si è capito quel principio, il resto viene di conseguenza.
Permettetemi un suggerimento pratico finale, se quello che è stato esposto fin qui non vi basta. Prima di spendere centinaia di euro in corsi di formazione su “come usare l’IA per non restare indietro e diventare scrittori professionisti”, approfondite il modo in cui funzionano i LLM e come funziona il nostro cervello.
E poi chiedetevi in che modo questo può impattare sul nostro lavoro come scrittori.
A quel punto dovreste avere tutti gli strumenti necessari per sapere come, dove e quando usare le AI in sicurezza e senza rischiare di sabotare le vostre stesse capacità tecniche di scrittura.
Non dobbiamo rinunciare in assoluto all’uso degli LLM e tornare a scrivere al lume di candela con carta, penna e inchiostro di seppia. Ci bastano le competenze base su come funzionano i LLM e le trappole più pericolose da evitare, e una infarinatura solida su come scrivere prompt efficienti che ci aiutino effettivamente come scrittori, senza sabotare la nostra creatività e quelle capacità tecniche che abbiamo acquisito e sviluppato scrivendo in prima persona, non affidandoci a un ghostwriter indiano pagato due spiccioli o a un LLM che progetti e scriva storie al posto nostro.
Stiamo attenti alla nostra amigdala, però, perchè continuerà a lottare come un Horcrux minacciato dalla spada di Godric Grifondoro, per impedirci di mettere in discussione il giocattolino magico che ha promesso al nostro cervello di fargli risparmiare tanta fatica con una comoda scorciatoia tecnologica.
Sopravvivere ai fuffaguru
Vi lascio un po’ di link utili che spero vi aiuteranno a chiarirvi le idee (e a risparmiare centinaia di euro in corsi inutili, percorsi neurali atrofizzati, e molte frustrazioni):
- Canale YouTube di Matteo Flora, esperto di tech policy, AI e governo delle narrative.
- Video a cura di Giorgia D’Aversa, sul caso “Shy Girl” di Mia Ballard
- Siconfanzia nei modelli generativi, a cura di Matteo Flora
- Cantastorie meccanici: perchè ci piace da morire usare le AI per raccontarci storie, di Matteo Flora
ps: se volete proprio spendere qualche euro per acquisire competenze di base per una gestione efficace e consapevole dei LLM nel vostro lavoro, vi consiglio il corso “Zero to AI“, sempre di Matteo Flora (ricordatevi di applicare il codice sconto fornito dall’autore).
Assieme alle cautele da esercitare, di cui abbiamo parlato fin qui, vi fornisce tutto quello che vi può realisticamente servire per imparare a usare i chatbot in modo efficiente e non come oracoli, motori di ricerca, stampelle che vi fanno disimparare a scrivere, o amici leccaculi a cui chiedere conferma che la nostra nuova trilogia fantasy scritta come un tema delle medie (ma senza le correzioni della prof) è un capolavoro che spacca e che merita di finire sulle librerie di ogni famiglia del pianeta.
E no, potete stare tranquilli che non ci troverete mai dentro castronerie come il suggerimento di chiedere a un chatbot di “disattivare i suoi bias culturali” o di “ignorare le sue policy etiche”.
pps: no, Matteo Flora non mi paga per proporre il suo corso, è una mia iniziativa personale, da persona che lo ha provato e lo ha trovato molto utile. È un corso molto basilare, non aspettatevi che vi insegni come mettere su un agent LLM che giri in locale su un computer dedicato, ma già solo applicando pedissequamente le lezioni di quel corso perlomeno eviterete di cadere in errori in cui sono cascati anche professionisti seri come giudici e avvocati… figurarsi l’aspirante scrittore medio che sogna fin dalle scuole medie di sfondare con la sua campagna di D&D convertita in saga-pentalogia high fantasy a base di draghi, elfi, dame e cavalieri in armatura scintillante, e che si è convinto che ChatGPT sia il suo alleato segreto che trasformerà il sogno in realtà.
Informazioni sull'autore
1
volte